实用教程
Opus 5.5 和 Astra 谁更适合设计?用三个任务做选择
用同一需求、局部修改和可用交付比较 Opus 5.5 与 Astra。附 20 分验收表、完整提示词与单个可用结果的成本算法。
可以把目前交给 Astra 的设计任务拿给 Opus 5.5 试一轮,但换工作流之前,要比较交付文件和返工量。一次有用的试用应包括提出创意、精确修改和可用交付三个环节。一张好看的截图只能回答其中一部分问题。
Anthropic 于 9 月 22 日发布了 Opus 5.5。编程成绩不能直接衡量广告质量。下面给的是一套对比方法,不是 Panelly 已完成的模型实测。
用同一个虚构项目开始
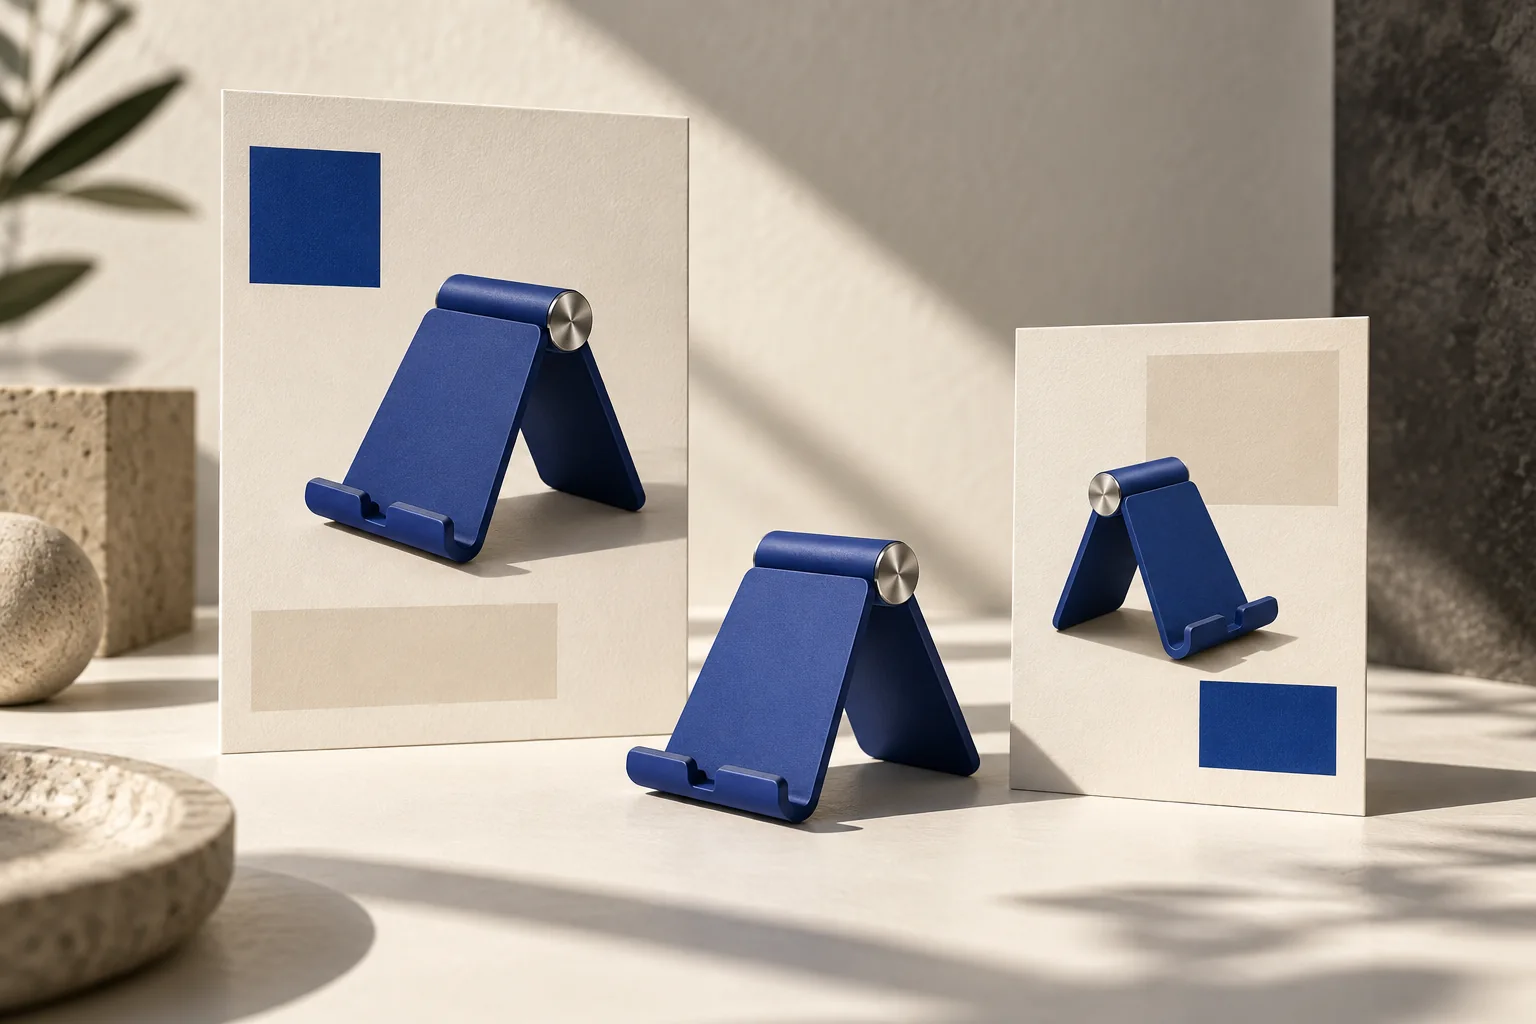
假设要推广一款蓝色折叠手机支架,受众是在小餐桌旁开视频会议的人。给两个模型相同的正面照片、折叠图和已知尺寸。这个练习唯一批准的卖点是支架能让手机立起来,不要增加充电、防水或虚构折扣。
开始前保存需求原稿。两边使用相同的素材、可用工具、输出格式和时间额度,并记录所用应用与模型设置。没有执行工具的网页聊天,与能够查看网页渲染结果的智能体相比,差异不只来自模型。
| 环节 | 交付物 | 能看出什么 |
|---|---|---|
| 创意 | 三个广告方向,各含四格叙事 | 是否换了说服思路,而不只是换形容词 |
| 修改 | 只改支架颜色和最后的 CTA | 已通过的构图与商品事实能否保留 |
| 交付 | 放入所选广告的响应式 HTML 概念页 | 好看的提案能否变成可用文件 |
保留每轮第一次输出,包括失败结果。每轮只追加一次反馈;如果不限次数地补救,就很难判断哪个模型真正节省了时间。
评分前先定一票否决项
每项打 0–2 分:0 分代表不可用,1 分代表需要明确修正,2 分代表满足本次需求。先隐藏模型名称再评分。以下权重刻意让商品真实性高于装饰效果。
| 项目 | 权重 | 看什么证据 |
|---|---|---|
| 商品与批准卖点准确 | 3 | 外形、功能、文案与资料一致 |
| 创意思路不同 | 2 | 三个方向使用不同场景或顾虑 |
| 视觉层级清楚 | 2 | 能辨认商品、承诺和下一步动作 |
| 修改范围受控 | 2 | 只改变明确要求的细节 |
| 文件可以交接 | 1 | 文件能打开,移动端正常,链接符合要求 |
单项分数乘以权重,满分 20。即使画面得分很高,只要编造了商品功能,就不应通过。这是编辑验收方法,不是科学基准测试。团队使用时,可让另一位同事独立评分;意见不一致就回到具体作品上讨论。
可直接使用的对比提示词
为附件中的蓝色折叠手机支架提出三个广告方向。受众:在小餐桌旁开视频会议的人。已确认事实:它能让手机立起来。未知:充电、防水、价格。不要编造这些信息。
每个方向说明受众问题、视觉钩子、四格顺序和一个 CTA。三个方向的说服思路必须不同。随后推荐一个方向,用两句话解释取舍。
我选定后,请使用实际可用的工具制作指定交付物。如果无法渲染或查看结果,请明确说明。保留商品身份,标题和 CTA 可以直接包含在完整广告图里。
第一版之后,我会提出一次局部修改。请说明改了哪里,以及实际执行了哪些检查。没有执行的检查不要写成通过。
第二轮,两边使用完全相同的要求:“按提供的奶油白参考图修改支架颜色,把 CTA 改为‘查看支架’,保留相机角度、版式和其余文案。”如果某个输出没有可继续编辑图片的路径,就记录这一限制,不要悄悄换一道题。
算每个可用结果的成本
能拿到实际账单时就用账单。举个假设例子:六次尝试共花费 $3.60,得到三个通过验收的文件,平均每个 $1.20。另一个模型共花 $2.40,却只有一个结果可用,单个成本就是 $2.40。总费用更低,不一定代表可用结果更便宜。还要单独记录人工修正分钟数;订阅额度不是 API 账单。
保留现有 Astra 工作流作为基线。把选中的创意和商品参考图带到 Panelly 创作台,先制作完整广告,再通过聊天调整。这个交接流程不表示 Panelly 已提供这两个模型供用户切换。
常见问题
分数高就代表广告效果好吗?
不是。它衡量的是是否满足需求。点击、购买和受众反馈,需要流量条件可比的独立投放实验。
什么时候值得切换?
当某类任务持续以更少修改通过验收时,就切换这类任务。另一个模型仍然擅长的工作可以继续交给它,不必找一个适合所有任务的总冠军。